生物系统的模拟有望彻底改变生物医学研究,但研究人员仍在探索如何在不被海量数据淹没的前提下重现生命的复杂性。
正如每位游戏玩家所知,计算机几乎可以模拟任何事物:从日常的家庭琐事到多行星文明面临的危机。因此,模拟生命的基本单位——细胞——理应是一件轻而易举的事。然而,事实并非如此。
每个细胞都是一个由生物分子构成的复杂生态系统,这些分子彼此作用,并以人们至今仍不太理解的方式对外部信号做出反应。此外,适用于某一种细胞类型的规律并不一定适用于另一种。但在这种混沌之中依然存在着秩序。
“细胞是一个复杂的系统,同时也是一个高度稳健且富有韧性的系统,”美国加利福尼亚州斯坦福大学的生物工程师艾玛 · 隆德贝格(Emma Lundberg)表示,“但它也是一个高度结构化的系统——细胞具有架构。”在过去几年中,研究人员已经开始对这种架构进行逆向工程,旨在将庞大的分子数据库转化为“虚拟细胞”,即能够模拟细胞在静息状态以及响应外部刺激时的内部环境的模型。
目前,数个团队正在深入挖掘转录组学(基因表达)及其他数据集,以构建能够揭示疾病潜在生物学基础和潜在治疗干预切入点的模型。“我们必须将虚拟细胞视为实现特定目标的手段,对我来讲,这个目标就是能够加速假设的搜寻过程。”位于加州帕洛阿尔托的美国弧形研究所的机器学习研究员优素福 · 鲁哈尼(Yusuf Roohani)说。
然而,该领域距离成功构建功能完备的虚拟细胞还差得很远。德国亥姆霍兹慕尼黑研究中心的计算生物学家法比安 · 泰斯(Fabian Theis)表示:“我认为,除了想推销初创公司,否则没有任何一个理智的人会想声称自己已经构建出了虚拟细胞。”当前的模型可以捕捉静态细胞状态,但在准确预测动态变化方面仍显得力不从心。要让计算机内的模拟演化达到更高水平,需要更大容量的多样化数据,以及将这些数据整合起来的智能化策略。
坚实的基础
人工智能革命极大地激发了人们对虚拟细胞的热情,但在如何构建计算细胞模型这一问题上,科学家早已探索了数十年。“甚至在二十多年前,我们就已经有了‘虚拟细胞1.0’,当时人们试图利用微分方程来描述系统生物学。”加拿大多伦多大学的人工智能专家王波说。
此类模型的优势在于,它们植根于可测量且已被充分理解的生物化学和生物物理学原理,将描述代谢、通信和运动等细胞功能的方程串联在了一起。“你实际上获得了机制层面的理解——你能够正确地解释它们,而这非常具有吸引力。”隆德贝格表示。
例如,2026年3月,由美国伊利诺伊大学厄巴纳-香槟分校的扎伊达 · 鲁西-舒尔滕(Zaida Luthey-Schulten)领衔的团队公布了一个复杂的数学模型,该模型在一种高度改造版本的支原体中真实地复制了细胞分裂过程。而在布卢明顿的印第安纳大学,工程师保罗 · 麦克林(Paul Macklin)和他的团队花费了十多年时间开发了一个名为PhysiCell的框架,用以模拟人类细胞和组织对多种环境刺激的响应。麦克林表示,该模拟器在癌症生物学建模中已被证明非常有用,其应用场景包括模拟驱动癌症进展的因素或对免疫疗法的响应。
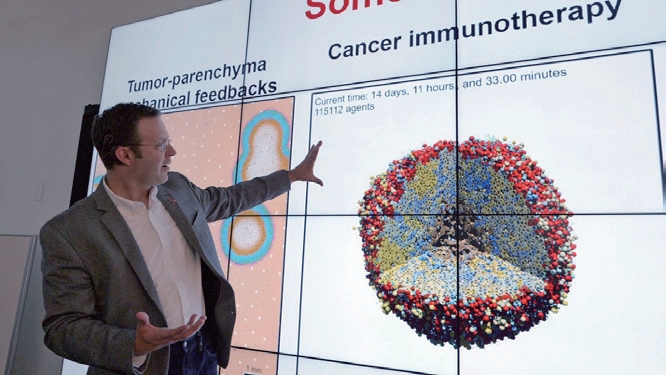
保罗·麦克林在印第安纳大学演示三维肿瘤-免疫模拟
尽管数学模型取得了这些成功,但它们天然地受限于研究人员对细胞生物学的理解。诸如人类细胞图谱(HCA)等计划已经产出了海量的基因表达及其他数据,包括蛋白质组学和表观遗传学数据,但要从成千上万的分子相互作用中提取出生物学意义是极其困难的。瑞士洛桑联邦理工学院的人工智能研究员玛丽亚 · 布尔比奇(Maria Brbi?)表示,这正是人工智能模型大显身手的时候:“它们非常擅长探索组合空间。”
关于真正的虚拟细胞该由哪些功能来定义,各方意见不一,但任何有意义的模拟至少应该能够表征给定细胞类型的基线状态,进而预测特定扰动如何改变该状态。许多尝试都依赖基于深度学习的“基础模型”,在此类模型里,人工智能算法要在庞大的未标记实验数据集中识别各种模式。
鲁哈尼将其与ChatGPT进行了类比。ChatGPT依托从互联网文本中收集的模式,能够针对几乎所有用户查询生成连贯的回答。“你可以在更广泛的细胞和生物学语境下创建更通用的表征。”他说。在最理想的情况下,生物学基础模型将能够推断出各种细胞类型会对未包含在原始训练集中的条件如何反应,甚至能对此前从未接触过的细胞类型做出有意义的预测。
单细胞基因表达数据是目前训练生物学基础模型识别不同细胞类型的首选途径,且此类数据易于获取。鲁哈尼和他的同事开发了一个名为scBaseCount的数据库,该数据库利用人工智能持续收集并统一处理转录组学数据,以用于模型训练。目前该数据库已收集了大约5亿个细胞的数据,且这一数字仍在增长。“这个数据量比第二大的单细胞数据存储库要多出好几倍。”鲁哈尼表示。
但是,人们不能仅凭细胞的定义特征(在人工智能模型语境下被称为嵌入)来简单地构建表征。虚拟细胞还必须学习不同的扰动如何影响细胞环境。要完善这些细节,需要研究人员在实验中系统性地使不同的基因失活,或将细胞暴露于各种药物中。王波说:“我们应该用因果数据建立因果模型。”此类数据集之一是由加州南旧金山的制药公司Xaira Therapeutics汇编的X-Atlas/Pisces数据集。该数据集可在开源人工智能平台上获取,它包含来自经靶向基因破坏失活的不同谱系共计2560万个细胞的基因表达数据。
扰动的隐患
理论上,由此获得的模型可以帮助用户推断是哪些基因异常驱动了特定肿瘤类型的生长,或是精准找出能够稳定病变细胞代谢问题的药物类别,而某些基础模型距离实现这些功能仅几步之遥。
例如,2026年1月,鲁哈尼和他的同事发布了Stack,这是一个基于scBaseCount数据集训练的模型。研究人员能够利用这些数据生成一张“扰动图谱”,以预测不同药物治疗在28种不同人类组织中的效果。而在3月,Xaira Therapeutics公布了基于该公司Pisces数据集训练的X-Cell模型。据王波介绍(他同时担任Xaira Therapeutics的生物医学人工智能负责人),尽管X-Cell并未就免疫T细胞活化过程进行过训练,但它仍能够预测该活化过程背后的基因表达变化。这使得该公司的科学家能够预测关闭该活化过程的机制——这对于炎症性疾病或其他免疫疾病可能是一种有效的干预手段。“我们不仅确认了已知的失活因子,如CD3及其家族,还发现了几种推测出来的T细胞失活因子。”王波表示。
然而,预测细胞扰动的影响仍然具有挑战性。王波提醒,这些模型只是朝该方向迈出的最初几步。“到目前为止,大家都只专注于细胞系,而细胞系是相对简单的生物系统。”他指出。这些模型可能无法准确映射到真实的器官和组织,而且,从原代细胞类型(直接取自人类标本的细胞)中收集有效规模的训练数据是极其困难的事。
此外,研究人员一直难以证明,相较于更简单的数学方法,基于转录组数据的基础模型能带来明显的性能提升。2025年,美国弧形研究所举办了“虚拟细胞挑战赛”,为各个团队提供了一个直接比拼模型预测性能的机会。尽管该活动在公众热情和参与度方面取得了成功——鲁哈尼表示,该活动吸引了来自100多个国家的约5000名参与者——但没有任何一个纯人工智能模型能够战胜结合了传统统计方法的模型。
布尔比奇在评估深度学习模型的稳健性时也遇到了类似的问题。在她看来,问题之一在于,传统的性能指标侧重于捕捉受扰动细胞与未受扰动细胞之间广泛的转录组差异。这意味着,微小但具有生物学意义的变化可能会被样本之间无关的背景差异所淹没,从而混淆人工智能的分析。“单细胞RNA测序数据存在噪声,”布尔比奇说,“我们观察到的那种差异可能是真实的生物学差异,但也可能是由实验伪差或其他变异源引起的。”
2025年,布尔比奇和她的同事发布了一个名为Systema的基准测试工具,该工具允许用户消除噪声,并专注于基因表达中的扰动特异性变化。鲁哈尼团队的扰动预测模型State(该模型旨在识别细胞群中的固有变异性)也解决了这一问题。通过将该方法与一种和Systema类似、专注于扰动特异影响而非整体基因表达的性能指标相结合,State能够准确预测测试数据集中受给定扰动影响最强烈的大约1/3的基因。与使用传统方法实现的7%相比,这是一项巨大的进步。
玛丽亚·布尔比奇利用人工智能将转录组数据整合到虚拟细胞中
构建完整图景
尽管人工智能模型在预测细胞行为方面尚未取得决定性的突破,但它们能够超越已有数据,对新的细胞、组织甚至物种作出推论。王波表示,这是传统计算方法无法实现的。“我们不能指望用线性模型构建这种虚拟细胞,”他说,“将合适的数据与合适的模型相结合很可能是更好的方法。”
这句话的重点在于“合适的数据”。“这其实与细胞的数量无关,”隆德贝格说,“关键在于:我们是否捕捉到了不同的疾病状态?我们是否捕捉到了不同的组织?”更高的多样性也意味着要超越转录组,转向一种叠加了染色质状态、细胞形状以及蛋白质表达和定位等生物学信息的“多模态”方法。
已有数个团队展示了基于非转录组数据训练出的模型的潜力。2025年10月,隆德贝格和同事们推出了SubCell,该模型基于人类细胞显微图像及其蛋白质含量分布进行训练。
SubCell借鉴了隆德贝格在人类蛋白质图谱(HPA)项目中的成果,该项目系统地绘制了每种人类蛋白质在各种细胞和组织内的亚细胞定位。SubCell基于这些图谱进行了训练,由此生成的嵌入则与名为ESM2的基础模型生成的嵌入进行耦合。ESM2由Meta人工智能部门的基础人工智能研究团队开发,该模型针对蛋白质序列进行了训练,能够对结构特征和演化相关性进行建模。
隆德贝格表示,这两套嵌入结合在一起,产生了一个大于其各部分总和的模型。“它在预测蛋白质功能、预测蛋白质-蛋白质相互作用等许多与理解生物学相关的任务方面,表现得比以往的模型好得多。”尽管SubCell完全使用人类细胞数据进行训练,但它也能完成诸如分析酵母细胞图像并确定其细胞周期状态等任务。
生物公司GenBio首席科学家邢波正在研究“世界模型”——这是传统基础模型的一种替代方案。这些模型针对包括结构、序列、图像和文本在内的各种数据类型进行训练,并产生多模态的计算机模拟系统,试图复制活细胞的内部环境和生物学活性。“基础模型在某种程度上更专注于细胞的表征学习,而世界模型则应更侧重于细胞的动态行为建模。”正主持开发一个名为AlphaCell的世界模型的同济大学计算生物学家刘琦表示。
邢波提出,GenBio正在开发的“人工智能驱动的数字有机体”(AIDO)世界模型将能够复制健康细胞和病变细胞的各种与生物医学相关的行为。“我们即将发布我们的第一个原型模型,它的起始是20个有限且明确的提示词,例如,‘基因编辑’或‘小分子干预’,”他说,“而在另一边,我们指定了想要看到哪些有限数量的输出,包括形态学、定位以及其他内容。”
话虽如此,但任何细胞都不是孤立存在的。试图对组织的单个构建模块进行建模,将不可避免地遗漏器官系统内部及系统之间的通信所产生的结果。邢波对GenBio的AIDO框架能够实现这种规模扩展持乐观态度,但那还需要数年时间。目前,像麦克林的PhysiCell这样的数学模型提供了一种强有力的解决方案。他的团队已经使用该框架模拟了从肿瘤微环境的免疫细胞浸润到大脑皮层早期发育的一系列过程。
2025年8月,麦克林和他的同事们,包括位于美国巴尔的摩的马里兰大学医学院的埃拉娜 · 费尔蒂格(Elana Fertig)以及约翰霍普金斯大学的珍妮维芙 · 斯坦-奥布莱恩(Genevieve Stein-O’Brien),公布了PhysiCell的升级版本,允许用户使用简单的陈述句来指定生物学场景。例如,用户可以声明某种特定药物增加了细胞周期活性,或是某种信号因子激活了免疫细胞的特定子集。随后,这些陈述会被转化为机器可解释的规则,为组织和器官建模提供一种用户友好的工具。但麦克林也看到了引入人工智能的机会。他指出,PhysiCell不适合捕捉分子尺度的细节,而基础模型目前在迈向细胞尺度及更大尺度时遇到了困难。“如果我们把这些结合起来,那一定会非常美妙。”他说。
细胞模拟绝非易事
尽管距离打造真正的虚拟细胞还很遥远,但开发者们已经找到了各自模型所具有的实用价值。“在公司内部,我们已经开始使用X-Cell来进行靶点识别等工作。”王波表示。
扰动模型还可以加速假设的生成和测试,使研究人员免于进行大规模的高通量筛选。这将使他们能够专注于验证由计算机生成的候选结果。“我认为我们将看到一种转变趋势,即先模拟、后实验。”隆德贝格说。由于这些模拟在不断演化,以捕获更多关于细胞环境及其周围环境的细节,它们将有助于减少药物开发和测试中对动物模型的依赖,从而产生以人类为中心的预测,降低临床试验中的毒性和失败风险。
但研究人员也需要克服生成式人工智能众所周知的局限性。聊天机器人经常会捏造“事实”,甚至主动误导用户,而图像生成算法则容易出现幻觉般的奇想。邢波警告道,早期模型在本质上将是对生物学机制的模拟,而非细胞现实的真实复制。因此,他和该领域的其他人士支持尽早发布并公开测试模型以及用于训练模型的数据集,以便用户能够发现模型的优势和局限性。“一旦我们的虚拟细胞成型,我们就将向公众开放、供大家体验,”邢波表示,“可能会出现让我们尴尬不已的糟糕结果,但我认为这是我们必须经历的过程。”
资料来源 Nature